[视觉CoT-01] Multimodal-CoT
摘要
思维链(Chain-of-Thought, CoT)作为提升大语言模型(Large Language Model, LLM)复杂推理能力的重要方法,自2022年受到广泛关注以来,逐渐改变了大模型推理研究的范式。随着多模态大语言模型(Multimodal Large Language Model, MLLM)的发展,研究者开始将CoT从纯文本场景扩展到视觉-语言场景,并逐渐形成视觉CoT(Visual Chain-of-Thought)这一研究方向。视觉CoT的核心目标并不只是让模型“输出更长的解释”,而是通过显式的中间推理步骤,使模型能够对视觉信息进行分解、定位、整合和逐步推断,从而完成传统端到端方法难以处理的复杂视觉推理任务。本文从LLM中CoT的起源出发,讨论视觉领域引入CoT的必要性,并重点介绍视觉CoT早期具有代表性的工作 Multimodal Chain-of-Thought Reasoning in Language Models,分析其提出背景、核心思想、模型结构和实验结果,为后续梳理Visual CoT的发展脉络奠定基础。
从LLM中的CoT说起
CoT的提出
传统语言模型在面对复杂问题时,可以将其抽象为从输入到输出的映射:$x \rightarrow y $。这种方式要求模型直接从问题中预测最终答案。当问题本身具有较高的推理复杂度时,单步生成容易受到中间推理能力不足、信息组合困难等因素的影响。
如果能够将复杂问题拆解为一系列相互关联的中间推理步骤,让模型逐步生成推理过程,最终得到答案,则可以将上述过程表示为:
\[x \rightarrow r_1 \rightarrow r_2 \rightarrow \cdots \rightarrow r_n \rightarrow y\]其中,$r_i$表示第$i$个中间推理步骤。通过在提示中显式提供这种“问题—推理—答案”的结构,可以诱导模型执行更加系统的多步推理。
这一思想在Wei等人的工作 《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》 中得到了系统验证。该论文于2022年在NeurIPS发表,其核心发现是:对于具有足够规模的大语言模型,如果在few-shot prompt中提供包含中间推理过程的示例,模型能够学习这种分步推理模式,并在数学应用题、常识推理和符号推理等任务上取得明显的性能提升。
需要强调的是,CoT并不是一种新的模型架构,而首先是一种推理诱导(reasoning elicitation)方法。其关键在于改变模型生成答案的方式:不再要求模型直接预测最终答案,而是显式生成中间rationale,再基于这些中间结果得到最终结论。
因此,CoT带来的核心变化可以概括为:
\[\text{Direct Answer}\rightarrow\text{Intermediate Reasoning} + \text{Answer}\]这为后续视觉CoT研究提出了一个自然的问题:
如果语言模型可以通过“语言状态序列”完成复杂推理,那么视觉语言模型是否也可以通过“视觉证据—语言推理—视觉状态”的连续过程完成复杂视觉推理?
CoT的进一步发展
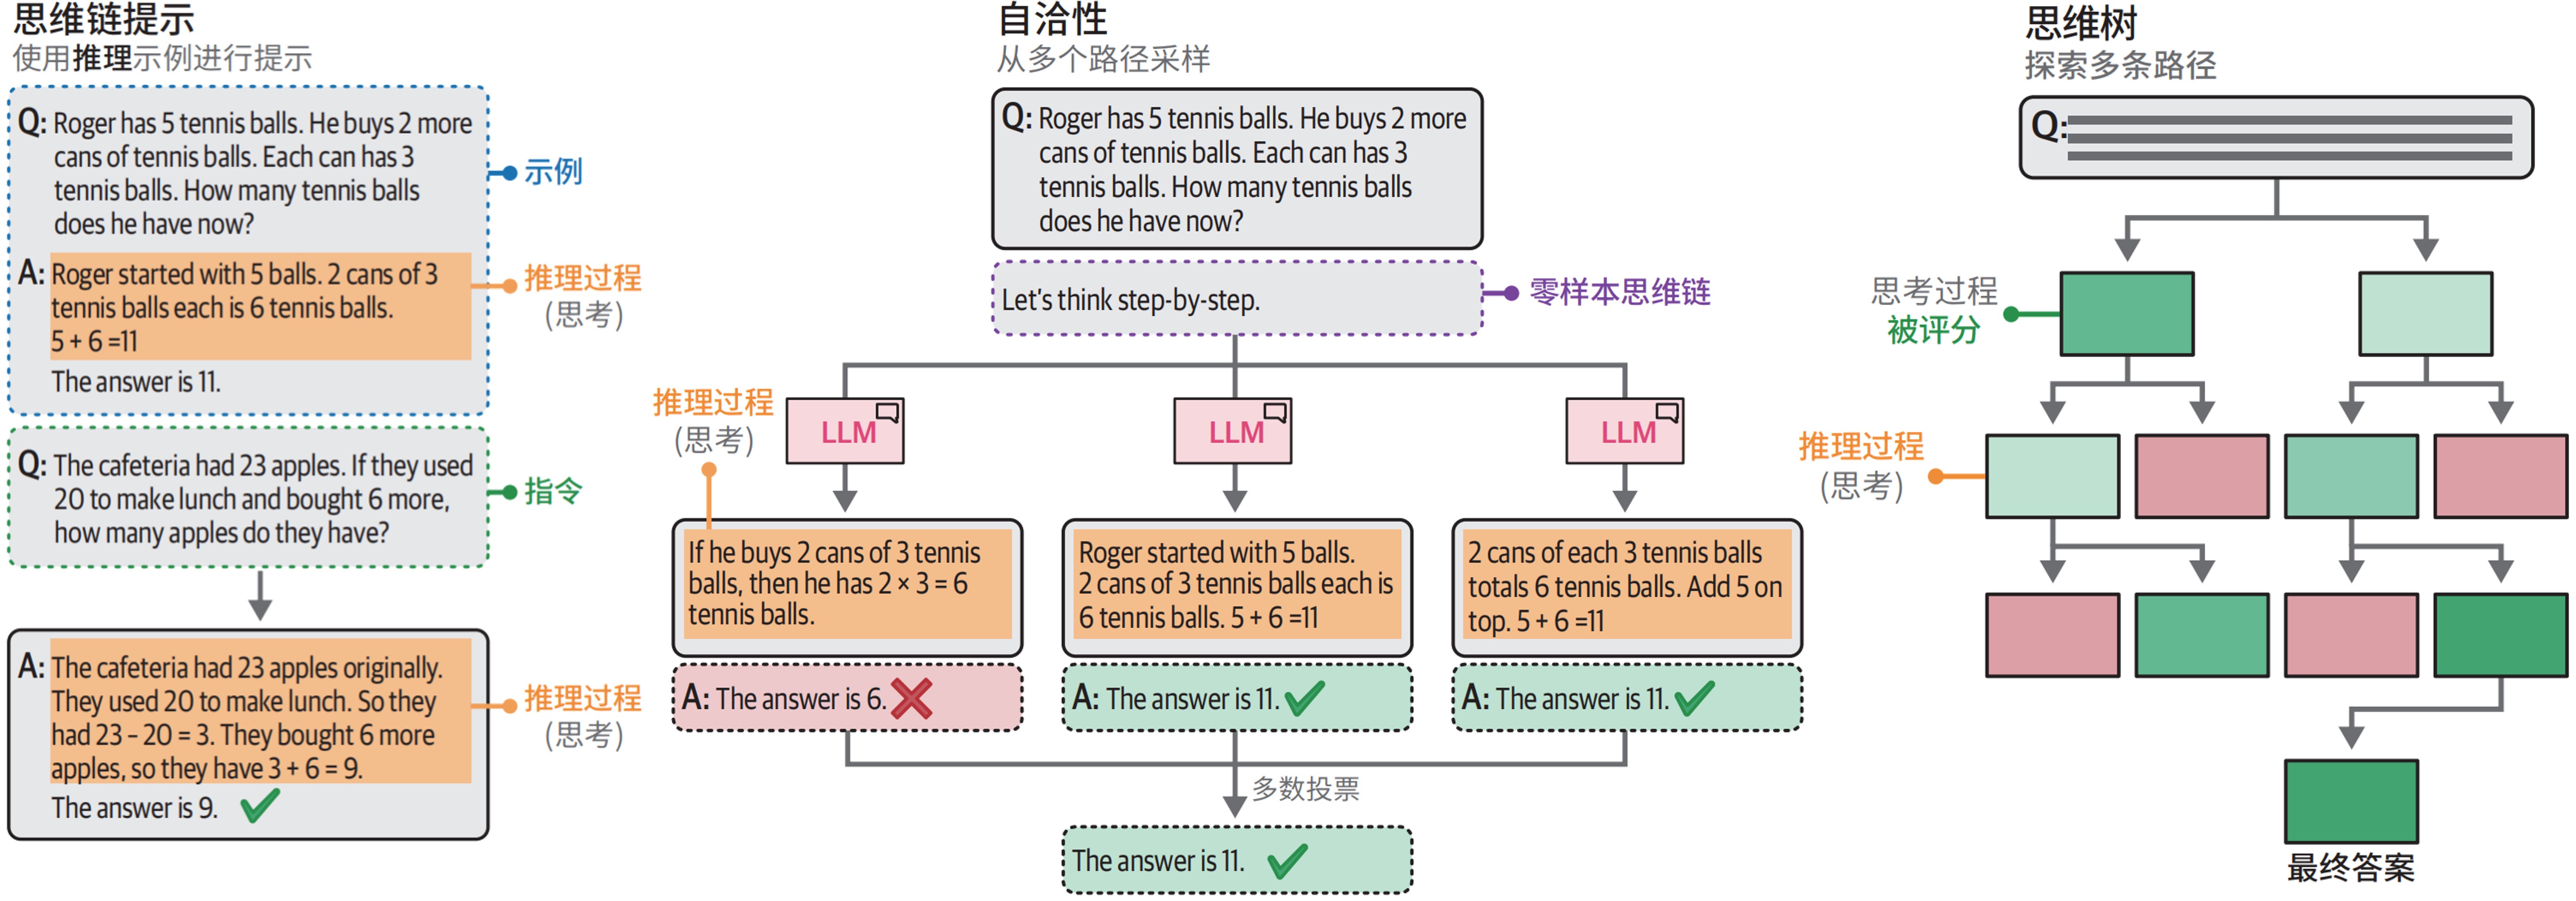
在Wei等人的工作之后,CoT研究逐渐从简单prompt engineering走向自洽性(Self-Consistency)、思维树(Tree-of-Thought,ToT)等。例如Wang等人提出的自洽性(Self-Consistency)方法通过让模型多次采样生成不同的推理路径,再通过多数投票确定最终答案,进一步提升了CoT推理的准确性和鲁棒性。这一方法有效缓解了单次推理可能出现的错误累积问题,成为CoT推理的重要增强技术。
这意味着研究重点由“如何让模型产生CoT”,逐渐转变为“如何让模型产生更可靠、更长、更有效的推理过程”,最终又进一步变成“推理过程本身应该采用什么形式”,这一问题正是视觉CoT后续发展的核心。
为什么视觉领域也需要CoT?
早期视觉语言模型通常遵循类似的处理范式:首先利用视觉编码器将图像转换为视觉特征或视觉token,再将视觉信息与文本问题共同输入语言模型,由模型直接生成最终答案。
这种模式对于图像描述、简单VQA、OCR等任务通常已经能够取得较好的效果。然而,当任务需要跨区域信息整合、多步逻辑推理或视觉证据与外部知识联合推断时,单次端到端预测便会面临明显挑战。
视觉任务的复杂性
现实世界中的视觉任务往往远比简单的图像分类或目标检测复杂,同时视觉推理具有天然的多步性。举一个VQA的例子,输入图像并询问“图中穿红衣服的人手里拿的是什么?”这实际上需要模型完成多个子任务:首先识别图像中的所有人物,然后根据颜色属性筛选出穿红衣服的人,接着定位该人的手部区域,最后识别手中持有的物体。这种需要多步推理、跨区域信息整合的复杂视觉任务,单靠一次前向传播难以准确完成,亟需引入分步推理机制。
更具挑战性的是科学问答、图表理解、几何证明等任务,它们不仅需要视觉感知,还需要结合领域知识进行逻辑推理。这类任务的复杂度远超传统VQA,传统的端到端方法难以胜任,而CoT的分步推理范式天然适合这类需要多阶段处理的任务。
多模态大模型的「幻觉」与推理缺陷
随着LLaVA、Qwen-VL、GPT-4V等多模态大语言模型的出现,模型在视觉理解方面取得了显著进展。然而,研究发现这些模型在复杂推理任务上仍存在明显缺陷。一方面,模型容易产生“幻觉”(hallucination),即在描述图像内容时编造不存在的信息,这在需要精确感知的任务中尤为严重。另一方面,模型缺乏可解释性,用户难以了解模型得出某个结论的依据,这在医疗诊断、自动驾驶等高风险场景中是不可接受的。
CoT的引入有望缓解这些问题。通过要求模型显式输出推理过程,一方面可以约束模型「先观察、再推理、后回答」,减少跳过关键感知步骤导致的幻觉;另一方面,显式的推理链为模型决策提供了可解释的依据,便于人类审核和调试。此外,分步推理还能让模型在每一步聚焦于图像的特定区域或特定属性,避免一次性处理过多信息导致的认知过载。
视觉CoT的初步探索:Mutimodal-CoT
视觉CoT发展的初步探索阶段的核心问题是:能否将语言CoT的思想迁移到视觉语言模型?下这一阶段具有代表性的工作是Zhang等人于2023年提出的 《Multimodal Chain-of-Thought Reasoning in Language Models》。该工作将文本和图像共同纳入CoT推理过程,并提出一个两阶段的Multimodal-CoT框架,是视觉CoT发展过程中具有代表性的早期工作。
多模态CoT的挑战
在将CoT扩展到多模态场景时,一个直接的问题是:
如何把视觉信息引入推理过程?
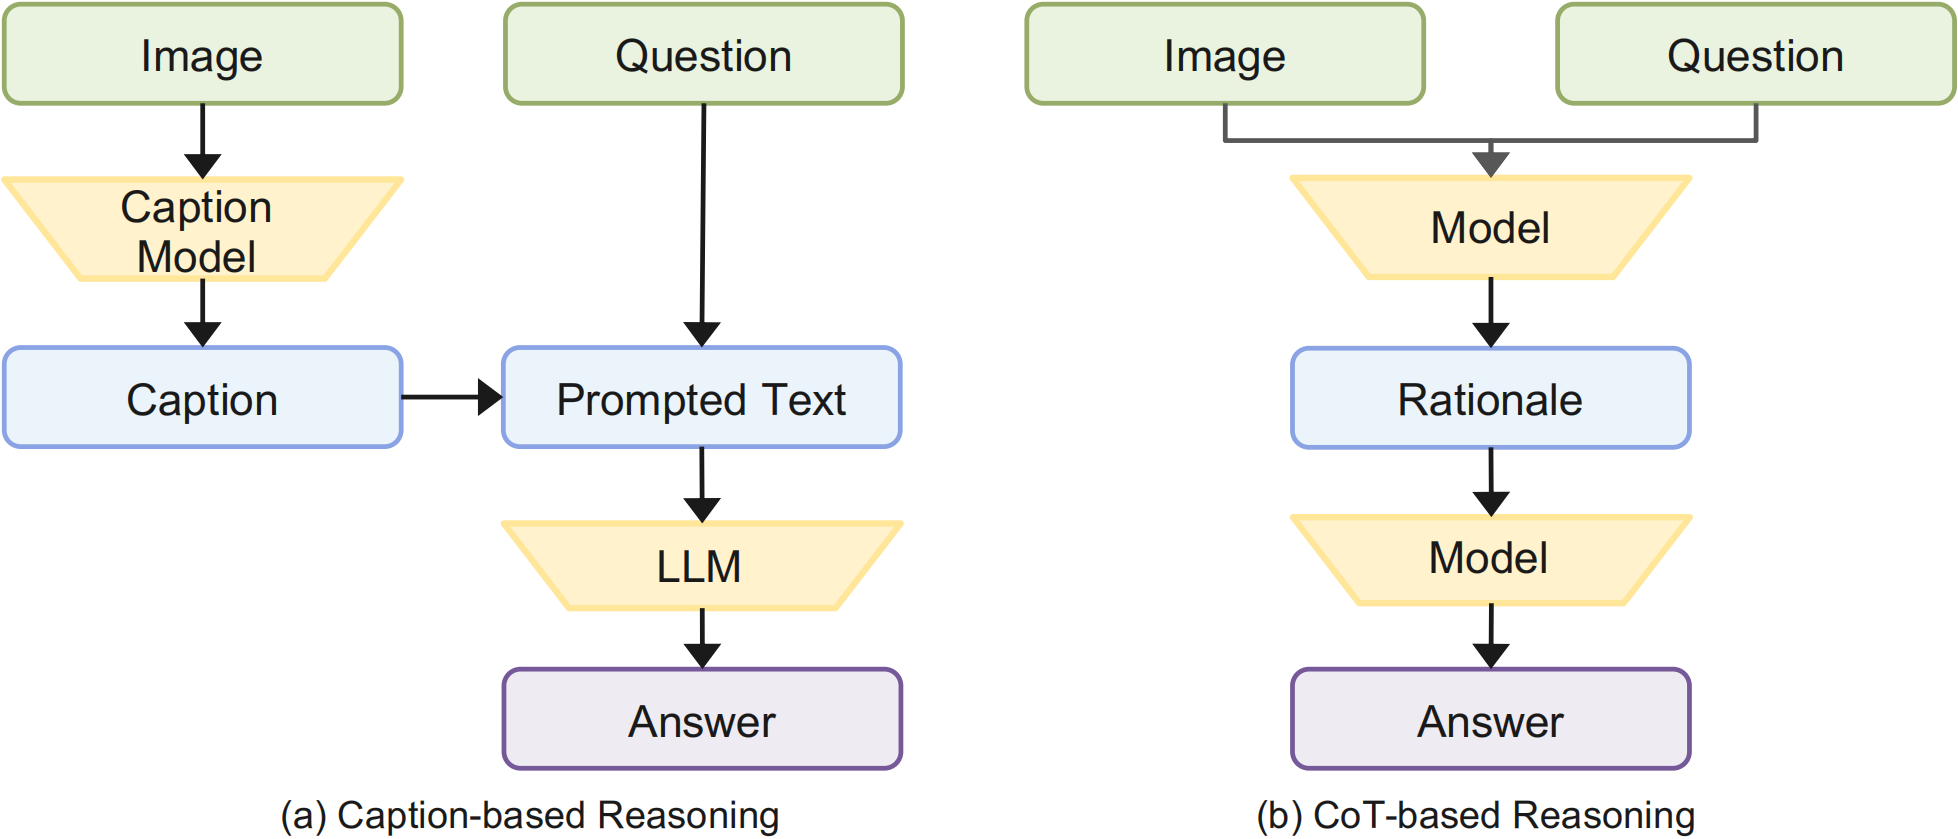
实现多模态推理主要有两种路径:一种直观的方法是首先利用大型多模态模型将图像转换为Caption,再将Caption作为文本输入语言模型。其优点是实现简单,但视觉信息经过文本化之后可能发生信息损失,而且需要额外调用大型模型生成描述。另一种方法则是直接利用视觉编码器提取图像特征,并在模型内部完成视觉与语言信息的融合。这样能够保留更加丰富的视觉信息,同时避免将图像完全压缩为自然语言描述。Multimodal-CoT选择了后者:使用冻结的视觉编码器提取视觉特征,并将其与文本表示进行融合,在相对较小的模型规模下完成多模态CoT推理。
针对在小模型上加入CoT是否可行,文章设计了Text-only环境下使用200M的T5模型(FLAN-Alpaca)在ScienceQA数据集上进行三种格式的推理:直接回答(No-CoT)、先推理后回答(Reasoning)、先回答后解释(Explaination)。实验结果表明,加入CoT后准确率相较No-CoT的81.63%跌至69.32%。这一实验证明了小模型引入CoT不仅没有帮助,反而会导致推理能力的下降,即模型是否能够生成与问题相关、与输入证据一致且能够帮助后续答案推理的CoT是研究的关键。
为了分析上述现象的原因,文章设计了将CoT拆解成两个阶段(QCM→R,QCMR→A)的实验,并进行了错误案例的分析。实验结果显示,生成的推理链RougeL很高,但是答案准确率依旧很低,针对错误样本的分析表明,推理链产生了“幻觉”(Hallucination)导致了准确率的下降,这说明了引入视觉信息的必要性。
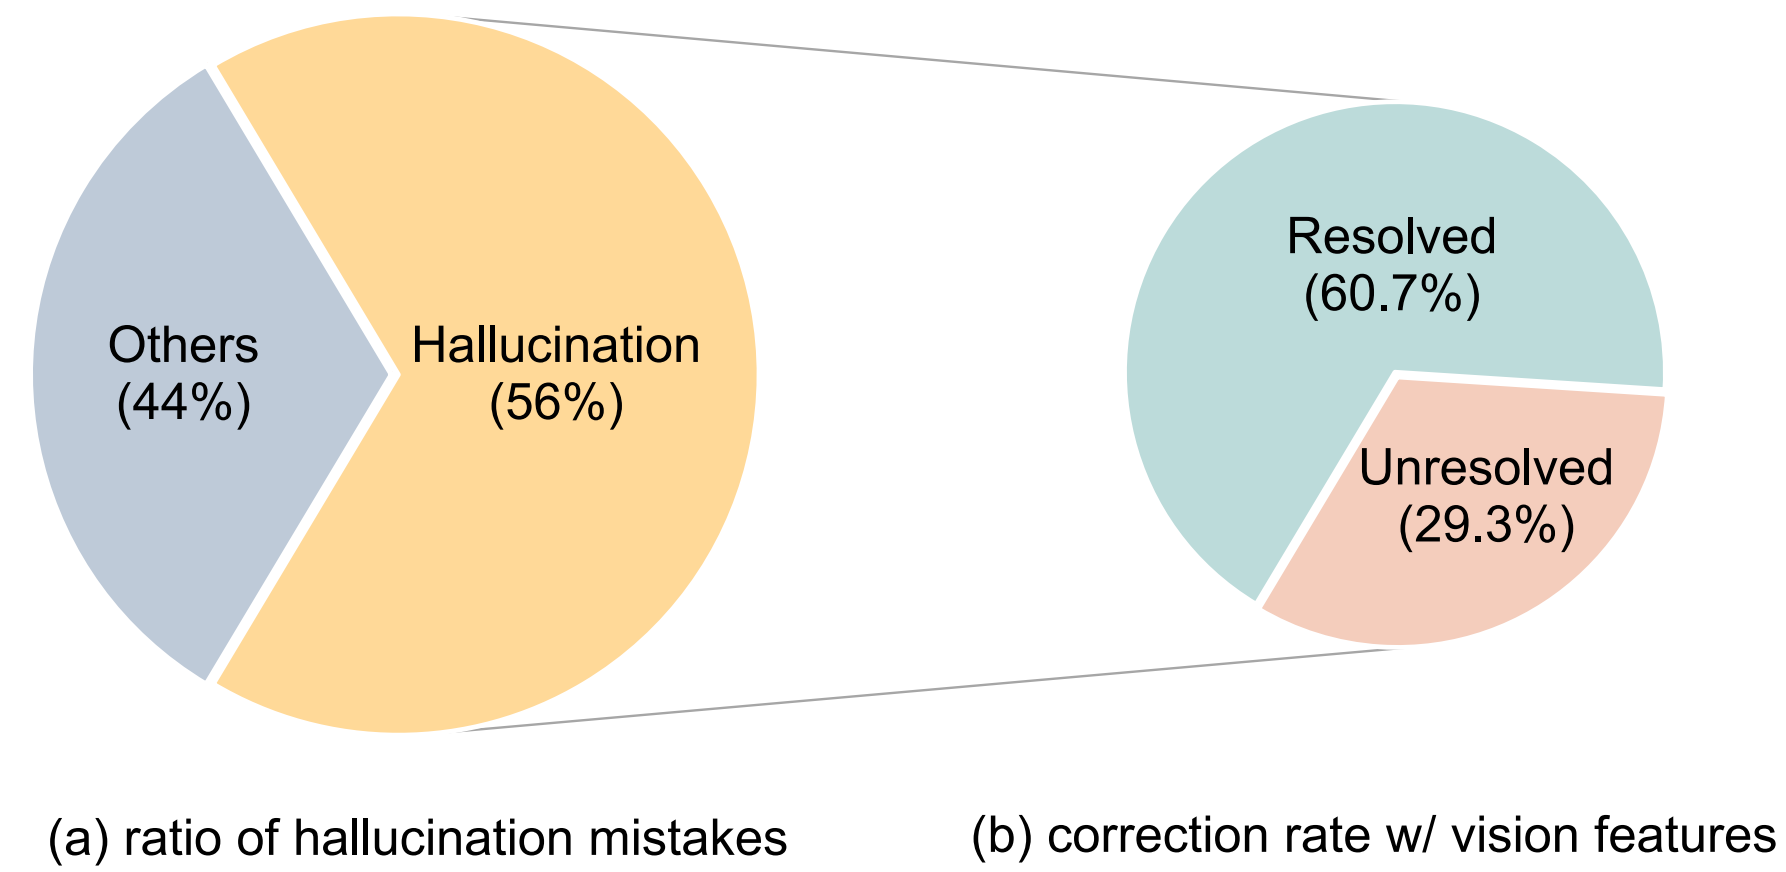
针对如何引入视觉信息,文章对比了加入Caption和加入ViT特征的实验结果,并于Text-only基线进行了比较。实验结果显示加入Caption效果甚微,说明文本表述无法弥补视觉的缺失;加入ViT特征后,准确率大幅提升,同时60.7%的幻觉错误被修正。该实验证明了必须用视觉特征而非文本描述辅助推理,同时两阶段配合视觉特征,效果选好于单阶段端到端的生成。
Mutimodal-CoT推理框架
上述实验分析证明了引入视觉信息的必要性,同时说明了为什么要使用视觉特征而非文本描述。下面介绍文章提出的推理框架,如下图所示。
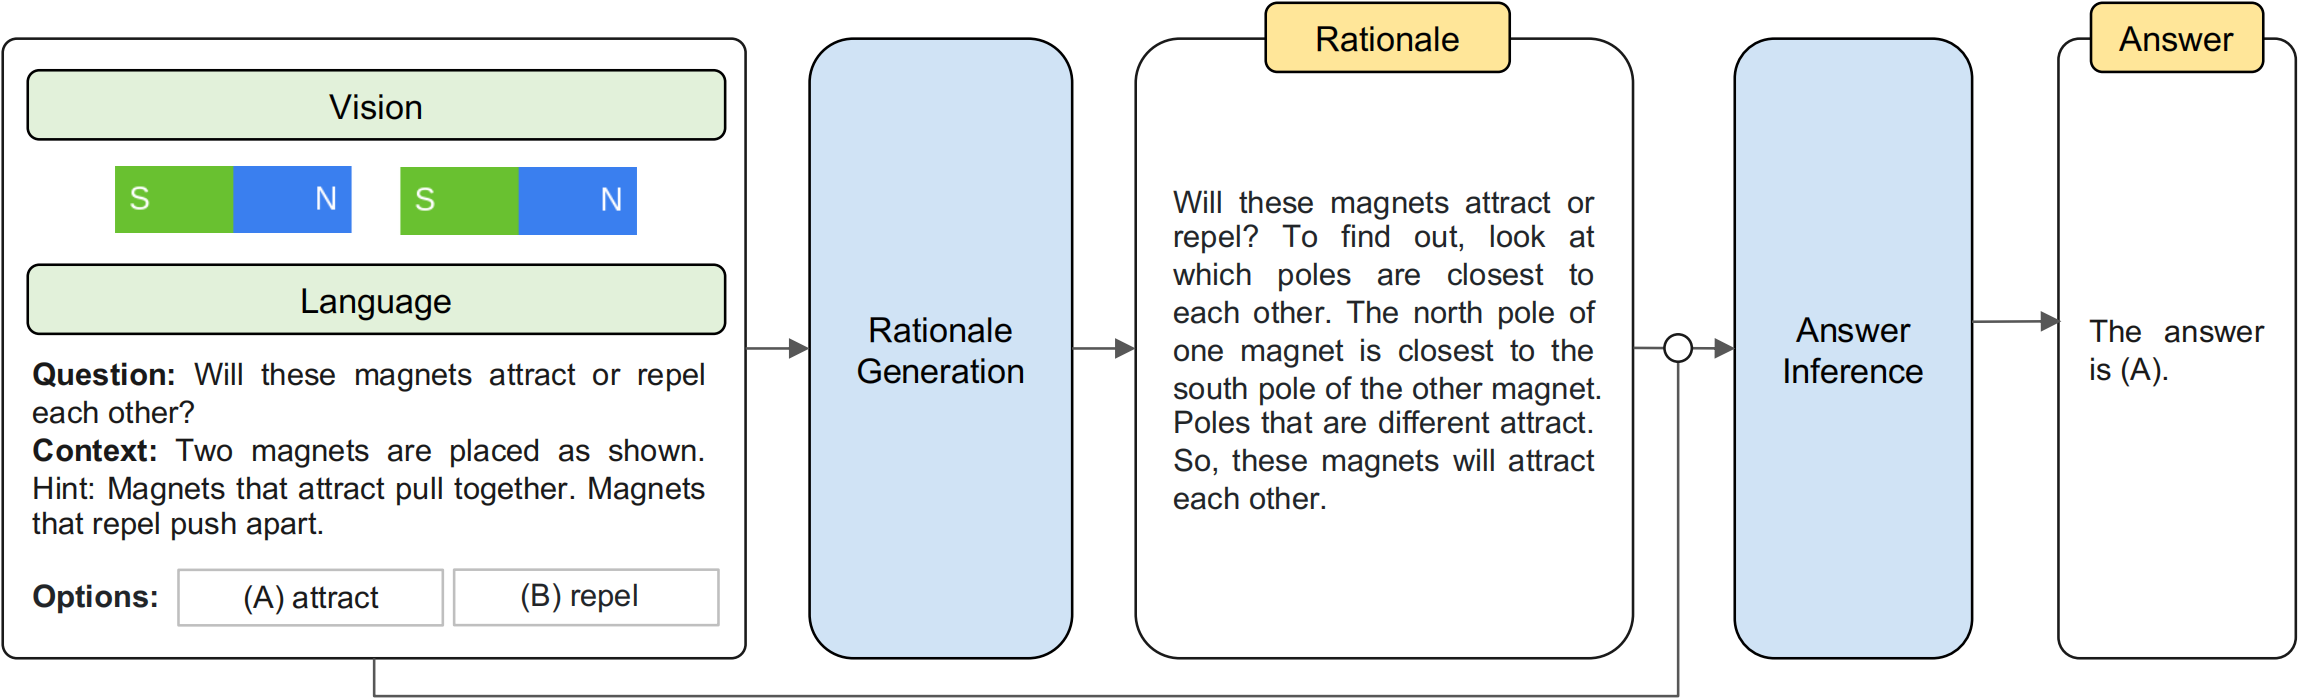
整体框架分为两个阶段:
-
Stage 1-推理链生成(Rationale Generation):$X$(Vison + Language)→$R$(Rationale)
-
Stage 2-答案推理(Answer Inference):$X^{\prime} $( Vison + Language + $R$)→$A$(Answer)
具体的,$X={ X_{\mathrm{language}}^{1},X_{\mathrm{vision}} }$,$R=\mathcal{F}( X_{\mathrm{language}}^{1},X_{\mathrm{vision}} )$,$X_{\mathrm{language}}^{2}=X_{\mathrm{language}}^{1} \circ R$,$X’={ X_{\mathrm{language}}^{2},X_{\mathrm{vision}} }$,$A=\mathcal{F}( X’ )$,其中$\circ$表示concatention。两个阶段使用相同的模型架构,但独立训练,参数不共享。
下面介绍模型设计。文章基于T5的Encoder-Decoder,设计了“Encoding→Interaction→Fusion→Decoding”四步流程。
1. Encoding
模型分别处理文本和图像映射到同一维度空间$d$。文本侧通过T5 Encoder获得文本表征,图相册通过冻结的ViT提取Patch特征,在经过投影矩阵$W_h$对齐维度。具体的:
\[H_{\mathrm{language}}=\mathrm{LanguageEncoder}\left( X_{\mathrm{language}} \right) , H_{\mathrm{language}}\in \mathbb{R} ^{n\times d}\] \[H_{\mathrm{vison}}=W_h\cdot \mathrm{VisonExtractor}\left( X_{\mathrm{vison}} \right) , H_{\mathrm{vison}}\in \mathbb{R} ^{m\times d}\]其中$n$为文本长度,$m$为图像Patch数。
2. Interaction
文章使用单头注意力,$H_{\mathrm{language}}$为Q,$H_{\mathrm{vison}}$为K、V,得到注意力输出$H_{\mathrm{vison}}^{\mathrm{attn}}$。
3. Fusion
为了平衡图像和文本模态的可信度,文章引入了门控因子$\lambda $:
\[\lambda =\mathrm{Sigmoid}\left( W_lH_{\mathrm{language}}+W_vH_{\mathrm{vison}}^{\mathrm{attn}} \right)\] \[H_{\mathrm{fuse}}=\left( 1-\lambda \right) \cdot H_{\mathrm{language}}+\lambda \cdot H_{\mathrm{vison}}^{\mathrm{attn}}\]4. Decoding
融合后的特征送入T5解码器,自回归地生成目标文本$Y$(第一阶段生成$R$,第二阶段生成$A$)。
\[p\left( Y|X_{\mathrm{language}},X_{\mathrm{vison}} \right) =\prod_{i=1}^N{p_{\theta}\left( Y_i|X_{\mathrm{language}},X_{\mathrm{vison}}, Y_{<i} \right)}\]实验验证
文章实验用到的数据集为ScienceQA和A-OKVQA,Backbone为T5-Base和T5-Large,用FLAN-Alpaca初始化。实验在8张NVIDIA Tesla V100 32G GPU上进行。实验选择了三类Baseline models,分别为VQA模型、语言模型和微调的VLM。主要实验结果如下表:
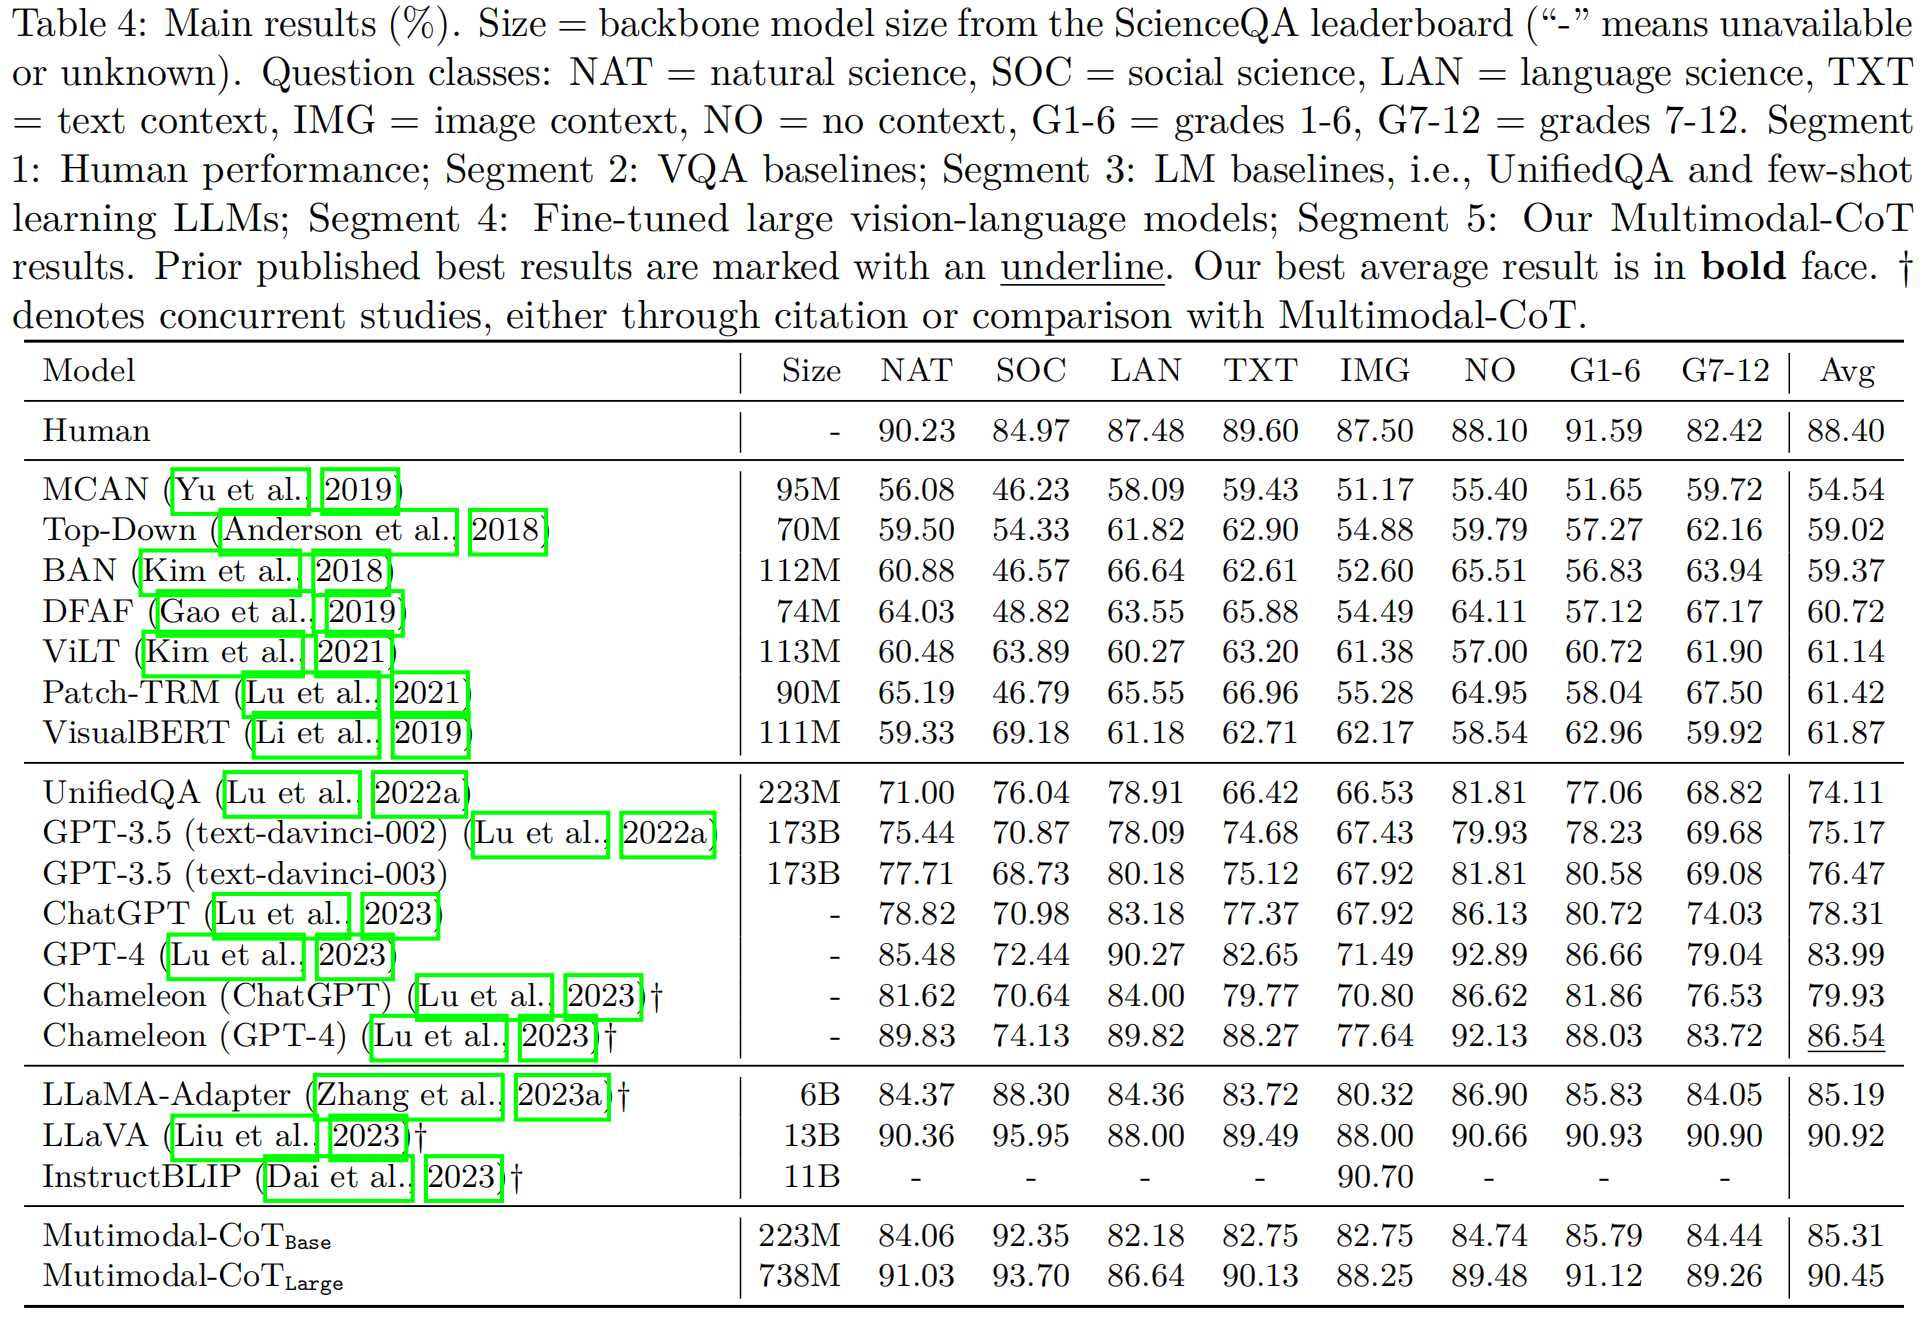
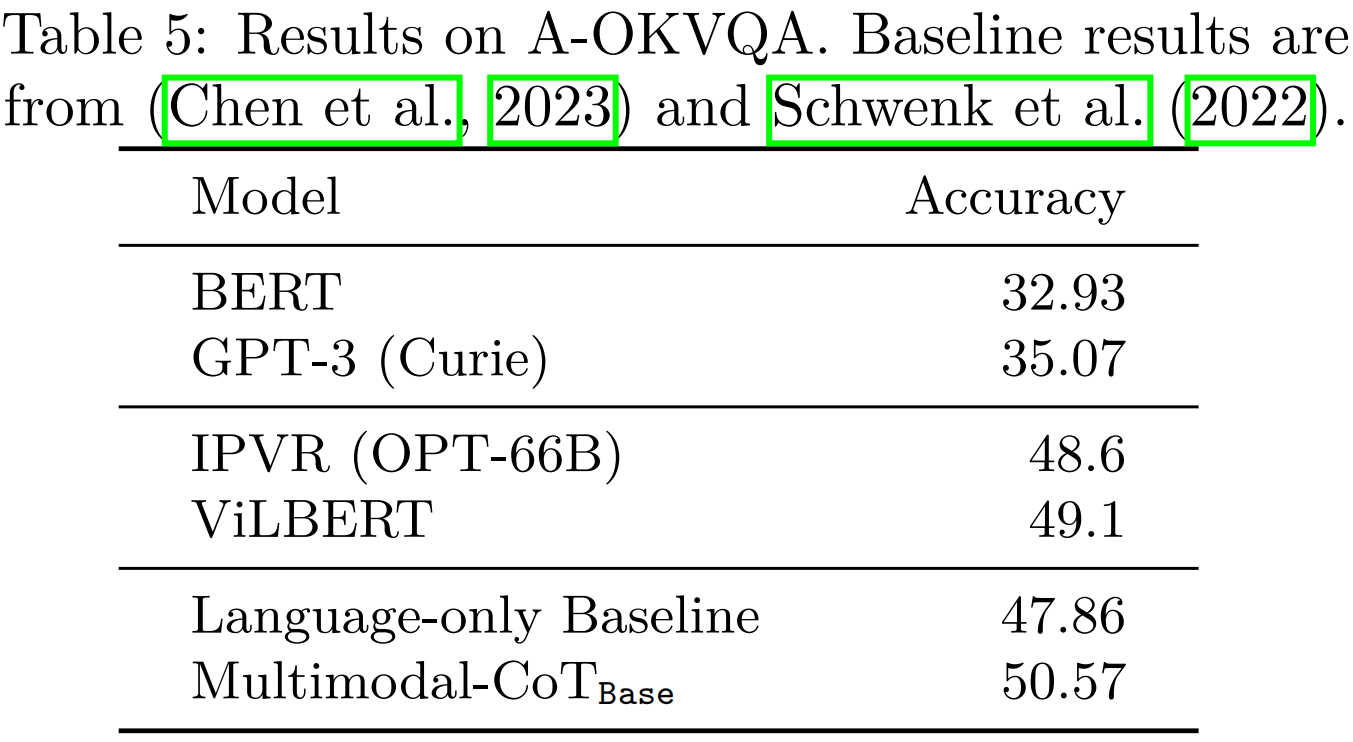
实验结果表明,在ScienceQA数据集上,738M参数的Multimodal-CoT Large达到90.45%,不仅超过同量级模型,甚至超过了175B的GPT-3.5(76.47%)和13B的LLaVA(90.92%),与GPT-4(83.99%)相比也有显著优势。在A-OKVQA上同样优于纯文本基线和传统VQA模型。证明了多个基准上地通用性和高效性。
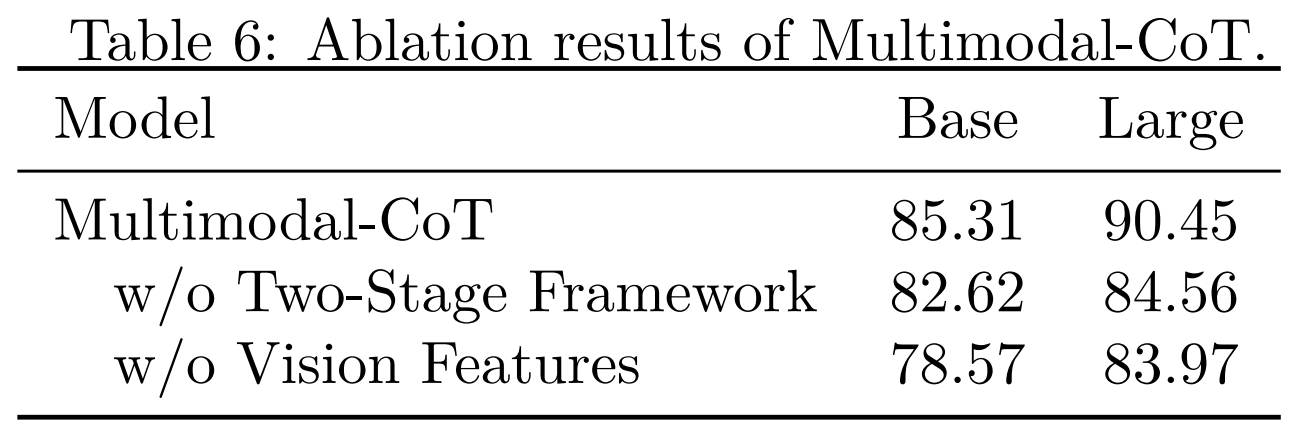
消融实验结果见上表,证明了Two-stage的有效性。
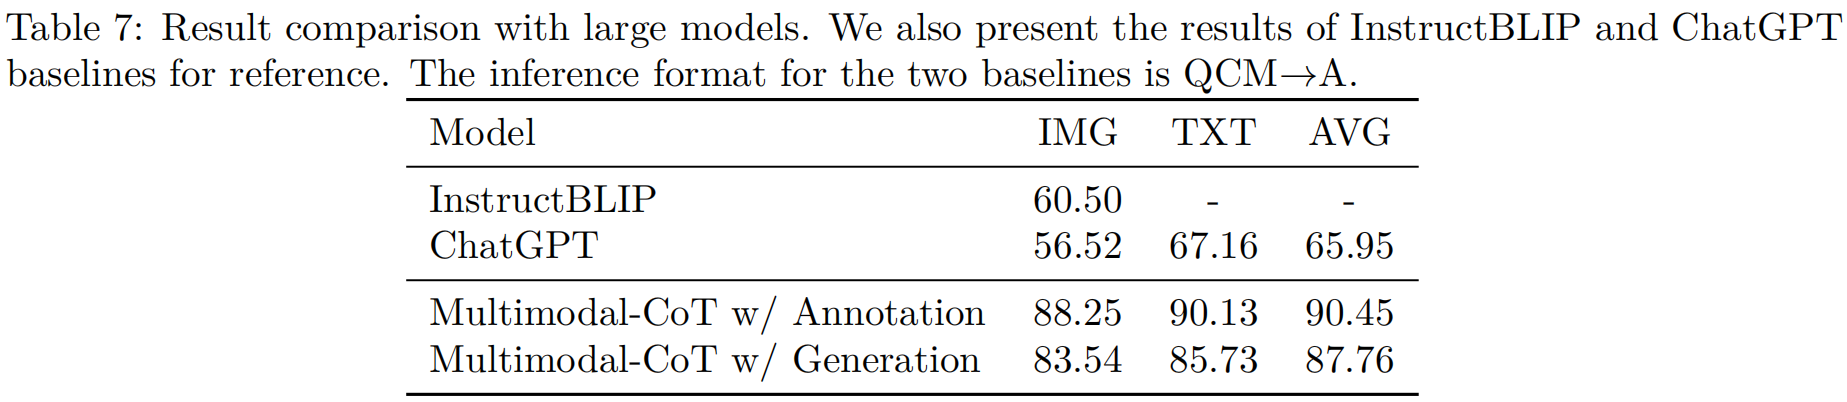
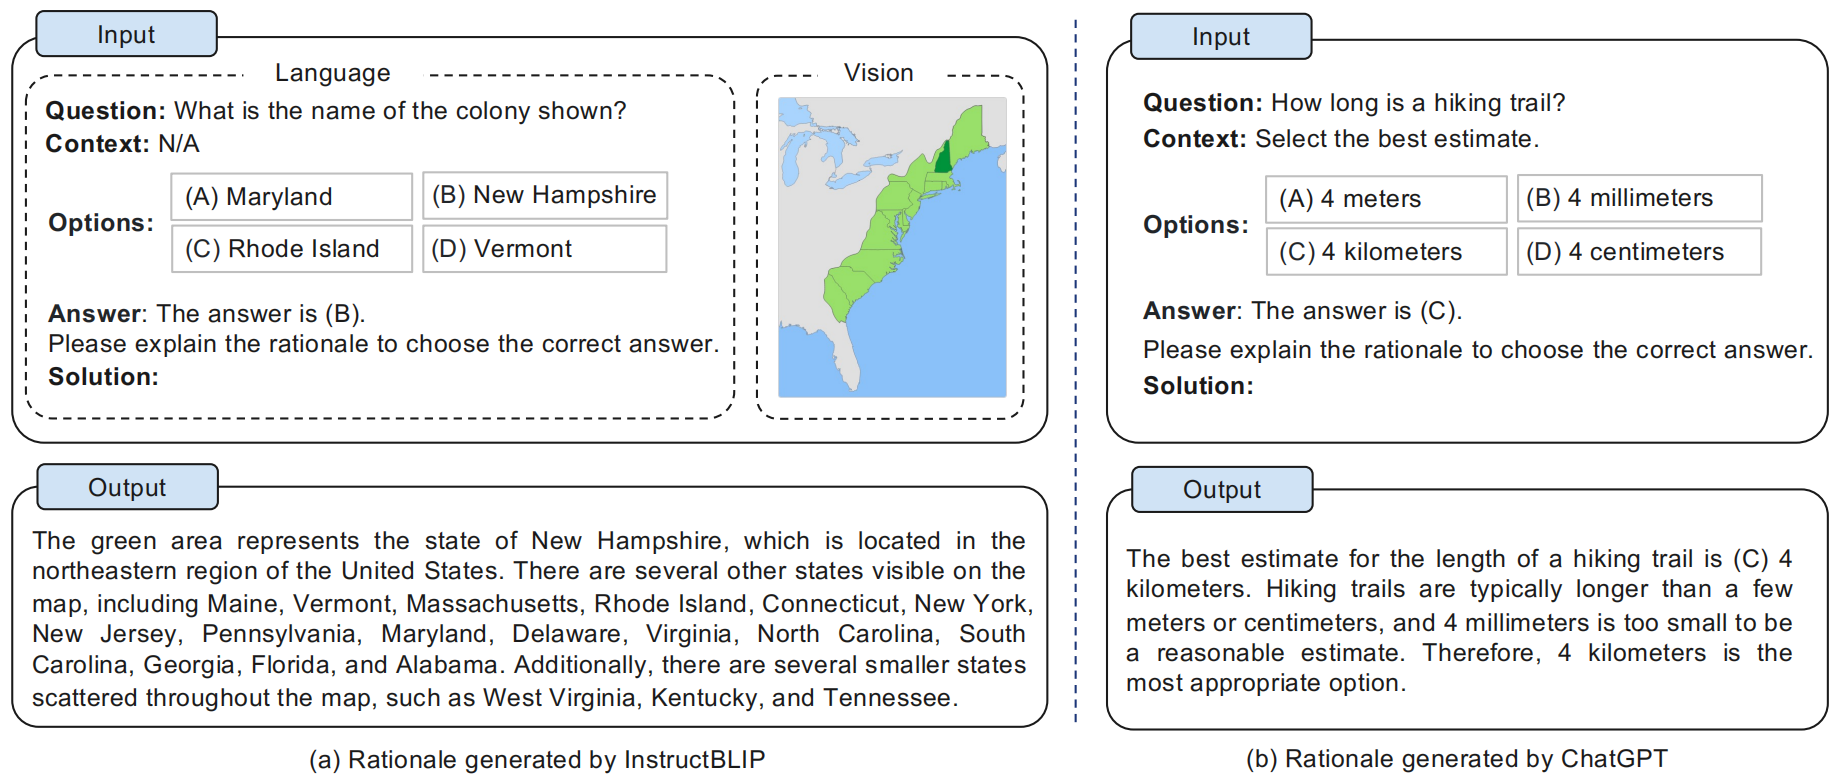
文章分析部分讨论了在没有人工标注Rationale情况下该工作的可行性。文章设计了用InstructBLIP和ChatGPT生成伪推理链,代替人工标注用以训练模型,结果如上表所示。对比性能略有下降,但是仍然超过了大模型进行zero-shot的效果,证明了该方法可以迁移到无推理链标注的多模态数据集上。
文章还更换Backbone和Vision Feature进行了测试。实验结果表明该方法对于各种Encoder-Decoder结构均有效;视觉特征上细粒度的Ptach级特征(ViT/CLIP)效果优于全局池化特征(ResNet)。
针对错误样本,文章进行了一定的分析,发现常识错误约占80%,逻辑错误占14%,CoT无关或为空占6%,一定程度上分析了模型的缺陷。
一些思考
本文很好的通过合理的结构解耦和模态对齐,实现了模型推理的大幅提升,但是仍存在以下问题:
- 文章使用的数据集ScienceQA,在纯文本No-CoT下可获得80%以上准确率,是否证明了数据集本身存在语言描述冗余的问题?如果在纯粹依赖视觉空间推理的数据集,本文方法的提升幅度可能会被放大,但也可能暴露视觉特征提取不足的新问题。
- 该框架使用并冻结了ViT,目的是节省显存,防止过拟合,但是实验数据集的图像与ViT训练使用的ImageNet可能存在Domain Gap。如果解冻ViT进行端到端微调,性能是否会进一步提升?还是会因数据量不足(仅12k训练集)而崩溃?
- 作者发现80%的错误来自“不懂常识”(如看不懂地图)。这是否意味着,单纯的多模态对齐(Alignment)无法解决所有问题,必须引入结构化的知识图谱(Knowledge Graphs)或更强的世界模型(World Models)?
参考
- Wei, Jason, et al. “Chain-of-thought prompting elicits reasoning in large language models.” Advances in neural information processing systems 35 (2022): 24824-24837.
- Wang, Xuezhi, et al. “Self-consistency improves chain of thought reasoning in language models.” arXiv preprint arXiv:2203.11171 (2022).
- Zhang, Zhuosheng, et al. “Multimodal chain-of-thought reasoning in language models.” arXiv preprint arXiv:2302.00923 (2023).
- Raffel, Colin, et al. “Exploring the limits of transfer learning with a unified text-to-text transformer.” Journal of machine learning research 21.140 (2020): 1-67.
- Lu, Pan, et al. “Learn to explain: Multimodal reasoning via thought chains for science question answering.” Advances in neural information processing systems 35 (2022): 2507-2521.
- Jin, Zhuoran, et al. “Look Light, Think Heavy: What Multimodal Chain-of-Thought Reasoning Can and Cannot Do.” Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers). 2026.
- Dong, Qihua, et al. “Revealing the Seen, Imagining the Beyond: A Survey of Image-Grounded Chain-of-Thought Reasoning in Multimodal LLMs.” Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers). 2026.